SSH وصل است ولی scp هنگ میکند؛ راز MTU در مهاجرت ابری
بعد از مهاجرت سرور به ابر، SSH وصل میشود اما scp و rsync وسط انتقال هنگ میکنند. ریشه ماجرا MTU کوچکتر شبکه overlay و مسدود بودن ICMP برای PMTUD است.
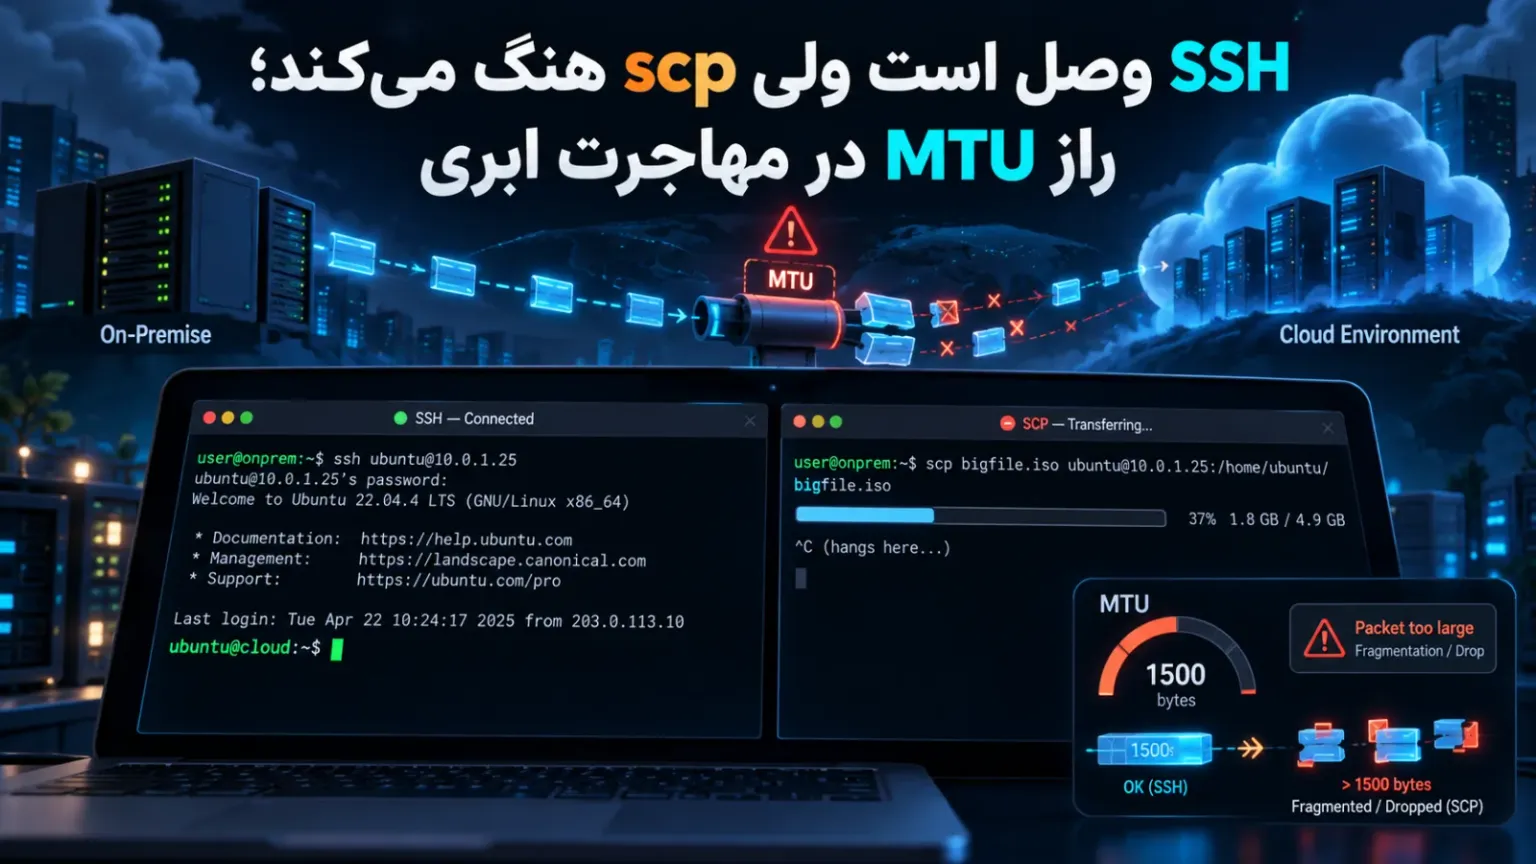
یکی از آزاردهندهترین سناریوها در مهاجرت ابری این است: سرور را از دیتاسنتر داخلی به ابر منتقل میکنی، SSH وصل میشود، پینگ جواب میدهد، اما بهمحض اینکه یک انتقال دادهی واقعی شروع میشود همهچیز هنگ میکند. خطای واضحی هم نمیبینی؛ فقط بیصدا میمیرد. در این مقاله علت این رفتار را میشکافیم و راهحل عملی و پایدارش را میبینیم.
شرح مسئله: کوچکها رد میشوند، بزرگها گم میشوند
نشانهها معمولاً اینگونه ظاهر میشوند:
- اتصال SSH باز میشود، تایپ روان است و لاگها را میخوانی؛ چون بستههای کوچک مشکلی ندارند.
- دستور
scpیاrsyncشروع میکند، چند درصد جلو میرود و بعد کاملاً فریز میشود؛ حتی تایماوت هم ممکن است بدهد. - دستور
git cloneروی مخزن بزرگ وسط کار گیر میکند. - درخواستهای
curl https://...که پاسخ حجیم دارند، با خطای زیر میمیرند:
$ curl -v https://example.com/large-file
* Connected to example.com (203.0.113.10) port 443
* TLS handshake in progress...
curl: (28) SSL connection timeout
و در انتقال فایل عملاً اینطور میشود:
$ scp bigfile.tar.gz user@server:/tmp/
bigfile.tar.gz        12%  512MB   1.2MB/s   eta 8m 12s
packet_write_wait: Connection to server port 22: Broken pipe
lost connection
نکتهی کلیدی این است که پینگ ساده (که بستهی کوچک میفرستد) سالم است و همین موضوع گمراهت میکند. مشکل فقط روی بستههای بزرگتر از یک اندازهی خاص ظاهر میشود.
علت ریشهای: MTU کوچکتر و ICMP مسدود
در دیتاسنتر داخلی، MTU شبکه تقریباً همیشه ۱۵۰۰ بایت است. اما در ابر، ترافیک VM از لایههای کپسولهسازی عبور میکند؛ VXLAN، Geneve یا GENEVE-based overlayها روی بستهی اصلی یک هدر اضافه میکنند. نتیجه این است که MTU مؤثر مسیر معمولاً بین ۱۴۰۰ تا ۱۴۵۰ بایت میشود، نه ۱۵۰۰.
حالا ماشینی که از دیتاسنتر آمده، اینترفیسش هنوز MTU=1500 اعلام میکند. برای بستههای کوچک (مثل دستدادن SSH یا کلیدهای فشرده) مشکلی نیست. اما وقتی یک بستهی ۱۵۰۰ بایتی با فلگ DF (Don't Fragment) فرستاده میشود، در گلوگاه overlay دیگر جا نمیشود. اینجا باید ICMP «Fragmentation Needed» برگردد تا مبدأ اندازه را کم کند (همان PMTUD). اما اکثر پلتفرمهای ابری ICMP را در مسیر فیلتر یا rate-limit میکنند؛ پس بسته بیصدا drop میشود و مبدأ هیچوقت نمیفهمد.
این پدیده Black Hole است: TCP دوباره و دوباره تلاش میکند، `ss -i` پر از retransmit میشود و اتصال در نهایت میمیرد. چون بستههای SYN و handshake کوچکاند، اتصال اولشه برقرار میشود؛ درست همان «SSH کار میکند ولی scp نه».
راهحل گامبهگام
گام ۱: دیدن MTU فعلی
اول ببین اینترفیس اصلی چه MTUای دارد و نامش چیست (در ابر معمولاً ens3 یا eth0):
ip -br link show
ip link show ens3 | grep mtu
اگر عدد ۱۵۰۰ دیدی و مقصدت ابری است، مشکوک شو.
گام ۲: پیدا کردن MTU واقعی مسیر با ping
ابزار ping با فلگ -M do اجازهی fragmentation نمیدهد و اندازهی payload را با -s تعیین میکنیم. یادت باشد 28 بایت هدر IP+ICMP روی payload میآید؛ پس برای MTU=1500 باید 1472 بفرستی.
# MTU 1500 → payload 1472
ping -M do -s 1472 8.8.8.8

# اگر شکست خورد، تدریجی کم کن
ping -M do -s 1422 8.8.8.8   # MTU 1450
ping -M do -s 1372 8.8.8.8   # MTU 1400
اگر ICMP بیرونی مسدود بود، پینگ را به گیتوی پیشفرض بزن که همیشه در دسترس است:
ip route show default
ping -M do -s 1472 10.0.0.1
ping -M do -s 1372 10.0.0.1
برای دیدن سریع PMTU هم میتوانی از tracepath استفاده کنی:
tracepath -n 8.8.8.8
بزرگترین اندازهای که بدون خطا رد میشود، MTU واقعی مسیر را به تو میدهد.
گام ۳: اعمال موقت روی اینترفیس
sudo ip link set dev ens3 mtu 1400
ip link show ens3 | grep mtu
بلافاصله بعد از این دستور، دوباره scp را تست کن. اگر روان شد، علت تأیید شده است. این تغییر موقتی است و با ریاستارت از دست میرود.
گام ۴: پایدارسازی پیکربندی
روی Ubuntu با netplan فایل /etc/netplan/01-netcfg.yaml را ویرایش کن:
network:
  version: 2
  ethernets:
    ens3:
      dhcp4: true
      mtu: 1400
و اعمال کن:
sudo netplan apply
اگر از NetworkManager استفاده میکنی:
nmcli connection show
sudo nmcli connection modify "Wired connection 1" 802-3-ethernet.mtu 1400
sudo nmcli connection up "Wired connection 1"
روی خانوادهی RHEL با ifcfg، در فایل /etc/sysconfig/network-scripts/ifcfg-ens3 خط زیر را اضافه کن:
MTU=1400
و سپس:
sudo nmcli connection reload
sudo nmcli connection up ens3
گام ۵: کلپ کردن MSS (اگر گیتوی دست خودت است)
اگر این ماشین نقش روتر یا گیتوی داخلی را دارد و ترافیک را forward میکند، بهتر است MSS را هم clamp کنی تا کلاینتها ایمن بمانند. مقدار MSS برابر MTU منهای 40 بایت (هدر IP و TCP) است؛ برای MTU=1400 میشود 1360:
sudo iptables -t mangle -A FORWARD -p tcp --tcp-flags SYN,RST SYN \
  -j TCPMSS --clamp-mss-to-pmtu
روی خود سرور هم میتوانی روی خروجی تنظیم کنی:
sudo iptables -t mangle -A OUTPUT -p tcp --tcp-flags SYN,RST SYN \
  -j TCPMSS --set-mss 1360
چطور مطمئن شویم مشکل واقعاً حل شده است
- دوباره تست پینگ بزرگ:
ping -M do -s 1372 8.8.8.8باید بدون خطا جواب دهد. - یک فایل چند صد مگابایتی را با
scpمنتقل کن و مطمئن شو سرعت پایدار است و قطع نمیشود. - در حین انتقال، در یک ترمینال دیگر این را بزن؛ MSS باید حدود ۱۳۶۰ باشد و retransmit بالا نباشد:
ss -i -t state established
- شمارندههای retransmit را چک کن؛ باید در بازهی کوتاه تقریباً صفر بمانند:
netstat -s | grep -i -E 'retrans|timeout'
اگر انتقال بزرگ بدون قطعی تمام شد و MSS درست گزارش شد، مشکل حل شده است.
پیشگیری و بهترین روشها
- MTU را جزء چکلیست مهاجرت بگذار. قبل از تحویل سرور، یک تست
ping -M doو یک انتقال بزرگ انجام بده. - MTU را از روز اول در provisioning ست کن؛ مثلاً با cloud-init تا ماشینهای جدید بدون دخالت دستی درست بالا بیایند:
#cloud-config
network:
  version: 2
  ethernets:
    ens3:
      dhcp4: true
      mtu: 1400
- مقدار MTU را بر اساس نوع شبکهی ابری انتخاب کن؛ overlayهای VXLAN معمولاً MTU مؤثر ۱۴۵۰ و بعضی پیادهسازیها ۱۴۰۰ میدهند. مقدار امن، کوچکترین مقدار قابل قبول کل مسیر است.
- در گیتوی داخلی خودت، ICMP نوع ۳ کد ۴ را هرگز فیلتر نکن و MSS clamping را فعال نگه دار. PMTUD بدون ICMP کار نمیکند.
- شمارندهی retransmit و timeout را در مانیتورینگ داشته باش؛ افزایش ناگهانی آنها اولین زنگ خطر مشکل MTU است.
قاعدهی طلایی مهاجرت ابری: اگر اتصال برقرار میشود ولی دادهی حجیم رد نمیشود، شک اولت به MTU باشد، نه فایروال و نه DNS.
نویسنده
تیم محتوای کلودیکپ
تیم فنی و محتوای کلودیکپ؛ مهندسانی که هر روز با DevOps، Kubernetes و زیرساخت ابری کار میکنند و تجربههایشان را اینجا مینویسند.
سوالات متداول این مقاله
چون بستههای SSH در ابتدا کوچکاند و از MTU مسیر عبور میکنند، اما انتقال فایل بستههای بزرگ با فلگ DF میفرستد. اگر MTU مسیر کمتر از ۱۵۰۰ باشد و ICMP برای PMTUD مسدود باشد، این بستهها بیصدا drop میشوند و اتصال وسط انتقال فریز میشود.
با ping و فلگ -M do اندازهی payload را بالا و پایین ببر. برای MTU=1500 مقدار 1472 بفرست و اگر شکست خورد کم کن تا به بزرگترین اندازهی سالم برسی؛ آن عدد بهعلاوهی 28 بایت هدر، MTU واقعی مسیر است. اگر ICMP بیرونی مسدود بود، همین تست را به گیتوی پیشفرض بزن.
برای خود سرور بله، چون مبدأ از همان ابتدا بستههای کوچکتر میفرستد. اما اگر سرور نقش روتر دارد یا کلاینتهای دیگری پشت آن هستند، بهتر است روی گیتوی هم TCP MSS clamping را فعال کنی تا همهی اتصالها ایمن بمانند.
کلودیکپ در این زمینه چه کمکی میکند؟
مشاوره DevOps
ارزیابی فرآیندهای فعلی توسعه و عملیات و طراحی نقشهراه فنی متناسب با اهداف کسبوکار شما.
مشاهده جزئیات خدمتمعماری زیرساخت ابری
طراحی زیرساخت مقیاسپذیر، امن و مقرونبهصرفه روی AWS، Azure یا Google Cloud.
مشاهده جزئیات خدمتمهاجرت به ابر
انتقال ایمن و برنامهریزیشده زیرساخت و برنامهها از سرورهای سنتی به فضای ابری.
مشاهده جزئیات خدمت
قفل state ترافورم گیر کرده؛ آزادسازی امن بعد از کیل شدن apply
وقتی پایپلاین CI وسط اجرای apply کشته میشود، قفل state ترافورم در جدول DynamoDB باقی میماند و اجرای بعدی با خطای Error acquiring the state lock متوقف میشود. در این مقاله علت ریشهای، روش آزادسازی امن و راههای پیشگیری را بررسی میکنیم.
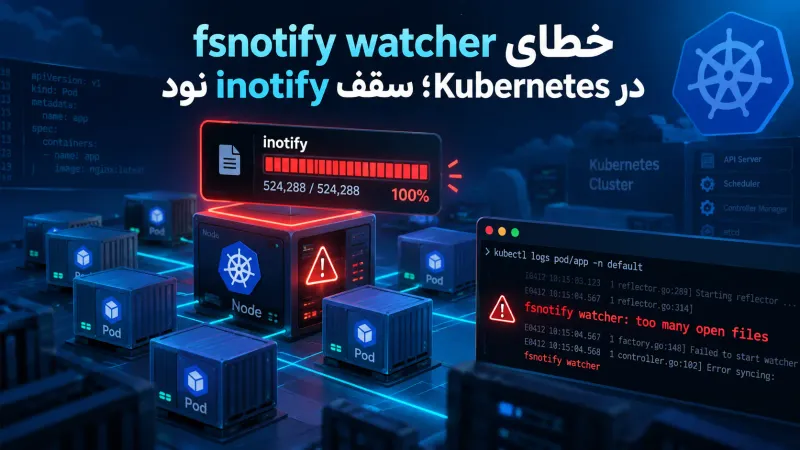
خطای fsnotify watcher در Kubernetes؛ سقف inotify نود
اگر پادهای Grafana، Prometheus یا هر اپلیکیشنی که از inotify استفاده میکند با خطای «failed to create fsnotify watcher: too many open files» کرش میکنند، مقصر سقف پیشفرض هسته لینوکس روی نود است.
پاد Kubernetes در وضعیت Terminating گیر کرده؛ آزادسازی امن
پاد در حالت Terminating گیر کرده و با kubectl delete پاک نمیشود؟ این مقاله علت واقعی (finalizer باقیمانده، نود NotReady، ولوم گیرکرده) و راهحل گامبهگام امن را نشان میدهد.
در پیادهسازی به کمک نیاز دارید؟
تیم کلودیکپ همین کار را هر روز برای تیمهای دیگر انجام میدهد. اگر جایی گیر کردهاید، با ما صحبت کنید.