سرور مهاجرتشده بوت نمیشود: وقتی initramfs درایور virtio ندارد
بعد از مهاجرت VM به ابر، اینستانس در پنل running است اما با پیام ALERT! UUID=... does not exist به شل initramfs میافتد. ریشه مشکل، نبود درایور virtio در initramfs و نامگذاری قدیمی دیسک ریشه است.
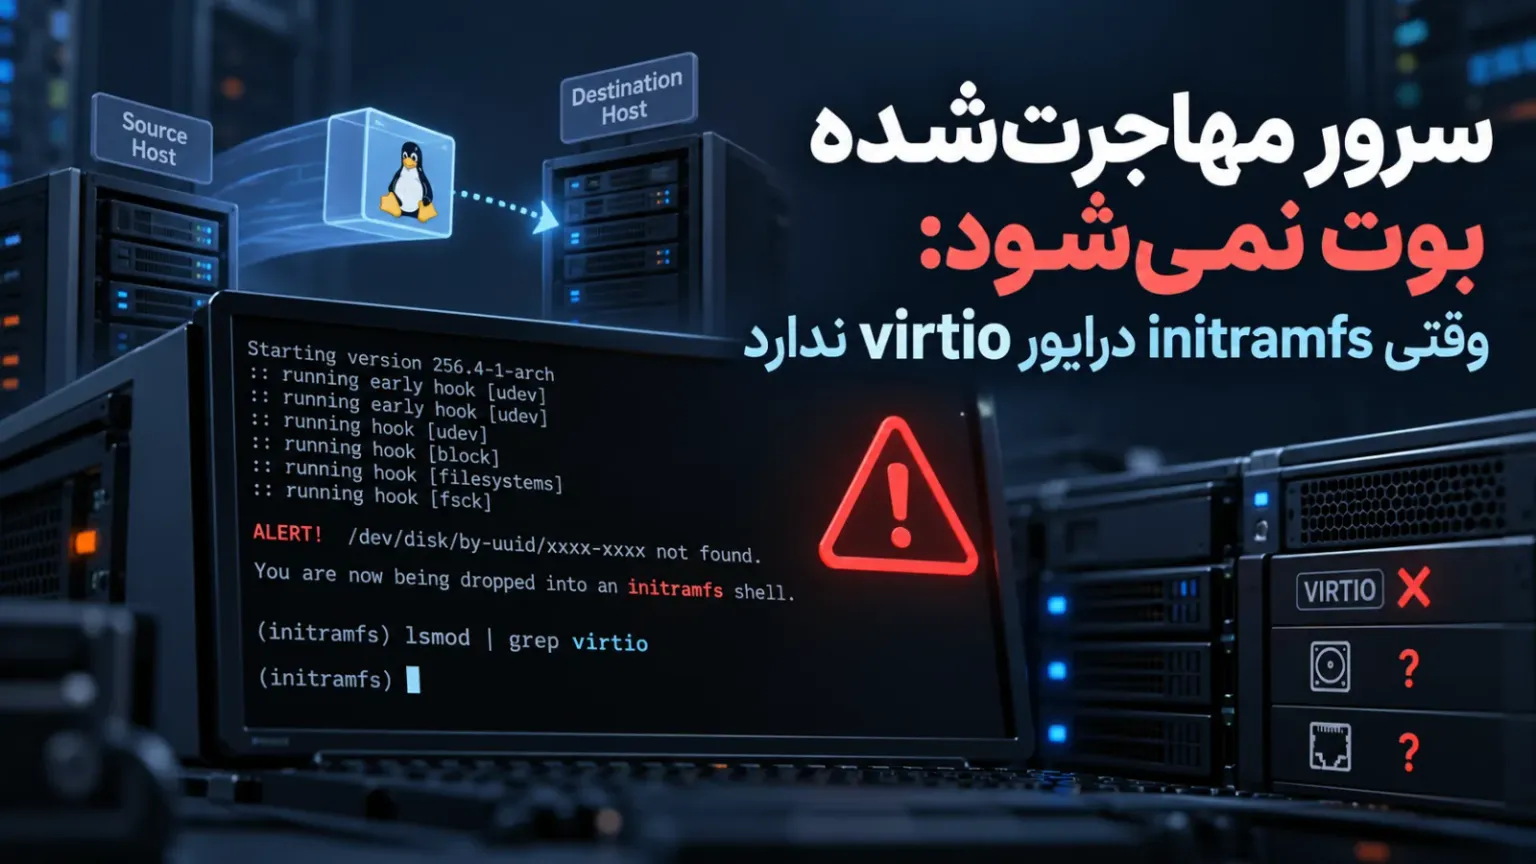
یکی از سناریوهای پرتکرار در پروژههای مهاجرت به کلودیکپ این است: سرور مجازی از دیتاسنتر قدیمی با فرمت qcow2 یا raw اکسپورت میشود، ایمیج آپلود و به دیسک اینستانس تبدیل میشود، اینستانس ساخته میشود و همهچیز درست به نظر میرسد. در پنل، وضعیت ماشین running است؛ اما نه SSH جواب میدهد و نه پینگ. به کنسول سریال نگاه میکنی و میبینی بوت همان اول متوقف شده است:
Gave up waiting for root file system device.  Common problems:
 - Boot args (cat /proc/cmdline)
 - Check rootdelay= (did the system wait long enough?)
 - Missing modules (cat /proc/modules; ls /dev)
ALERT!  UUID=9f3ac1e2-4b7d-4a11-9c2e-1d8f0a6b3c55 does not exist.  Dropping to a shell!

BusyBox v1.35.0 (Debian 1:1.35.0-4) built-in shell (ash)
(initramfs) _
در برخی توزیعها بهجای این پیام، کرنل پنیک میکند:
Kernel panic - not syncing: VFS: Unable to mount root fs on unknown-block(0,0)نشانههای تشخیصی که باید کنار هم بگذاری:
- در پنل کلودیکپ اینستانس
runningاست و کنسول سریال کار میکند؛ یعنی هایپروایزر و ماشین سالماند و مشکل داخل خود سیستمعامل است. - در شل
(initramfs)دستورls /devرا بزن: اگرvdaیاsdaرا نبینی، یعنی هیچ درایور بلوکی برای کنترلر جدید لود نشده است. - اگر
ls /dev/sdaیاls /dev/vdaوجود دارد ولی بوت ادامه پیدا نمیکند، مشکل درایور نیست؛ مقدارroot=در cmdline اشتباه است. - اگر سیستم بالا میآید ولی شبکه نیست، مشکل از initramfs گذشته و به udev و cloud-init رسیدهایم.
علت ریشهای
هسته لینوکس درایور دیسک و شبکه را از داخل initramfs لود میکند، نه از ماژولهای روی دیسک. initramfs در زمان نصب یا آخرین update-initramfs، بر اساس سختافزار همان لحظه ساخته شده است. روی سرور فیزیکی یا VMware، کنترلر دیسک megaraid_sas، mptspi یا ahci بوده و کارت شبکه e1000 یا vmxnet3. روی ابر کلودیکپ که مبتنی بر KVM است، همه اینها با خانواده virtio جایگزین میشوند. اگر initramfs با MODULES=dep ساخته شده باشد، فقط درایور همان کنترلر قدیمی داخلش کپی شده و درایور virtio_blk اصلاً وجود ندارد. نتیجه: کرنل بوت میشود، initramfs اجرا میشود، هیچ دستگاه بلوکی پیدا نمیکند، UUID ریشه را نمیبیند و به شل میافتد.
سه لایه مشکل را جدا کن، چون هر سه با هم شایعاند:
| لایه | روی سرور قدیمی | روی ابر کلودیکپ |
|---|---|---|
| کنترلر دیسک | megaraid_sas / mptspi / ahci | virtio_blk یا virtio_scsi |
| کارت شبکه | e1000 / vmxnet3 / tg3 | virtio_net |
| نام دستگاه | /dev/sda | /dev/vda (یا sda در حالت IDE-emulation) |
| نام اینترفیس | eth0 با قواعد udev ثابت | ens3 / eth0 بسته به تنظیمات ایمیج |
به این ترتیب حتی اگر درایور را اضافه کنی، ممکن است root=/dev/sda1 در cmdline یا /dev/sda1 در /etc/fstab هنوز به نام قدیمی اشاره کند و بوت در گام بعدی بشکند.
قانون طلایی مهاجرت: قبل از هر تغییری روی اینستانس، یک snapshot از دیسک بگیر. تمام دستورهای این مقاله روی نسخه snapshot قابل تکرار هستند و اگر جایی اشتباه شد، برمیگردی عقب.
راهحل گامبهگام
گام ۱: بوت در حالت rescue
در پنل کلودیکپ، اینستانس را خاموش کن (نه reboot)، سپس از بخش Console گزینه boot در حالت rescue را فعال کن یا ایمیج rescue را بهعنوان دیسک دوم وصل کن. بعد از بالا آمدن، دیسکها را شناسایی کن:
lsblk -o NAME,SIZE,TYPE,FSTYPE,MOUNTPOINT
blkid
vgchange -ay
خروجی نشان میدهد ریشه روی /dev/vdb1 است یا روی یک LV مثل /dev/mapper/vg0-root.
گام ۲: مانت کردن ریشه و ورود به chroot
mkdir -p /mnt/root
mount /dev/vdb1 /mnt/root          # یا mount /dev/mapper/vg0-root /mnt/root

for d in dev dev/pts proc sys run; do
  mount --rbind /$d /mnt/root/$d
done

chroot /mnt/root /bin/bash
اگر /boot پارتیشن جدا دارد، آن را هم داخل /mnt/root/boot مانت کن.
گام ۳: اصلاح initramfs (دلینوکس/دبیان/اوبونتو)
اول ببین واقعاً virtio داخل initramfs هست یا نه:
lsinitramfs /boot/initrd.img-$(uname -r) | grep -c virtio_blkاگر عدد صفر بود، ماژولها را اضافه کن. با printf این کار را انجام میدهیم تا از مشکلات heredoc در شل rescue دور بمانیم:
printf '%s\n' virtio virtio_ring virtio_pci virtio_blk virtio_scsi virtio_net | tee -a /etc/initramfs-tools/modulesسپس حالت ساخت initramfs را از dep به most تغییر بده تا همه درایورهای رایج داخل ایمیج قرار بگیرند:
sed -i 's/^MODULES=.*/MODULES=most/' /etc/initramfs-tools/initramfs.conf
grep '^MODULES=' /etc/initramfs-tools/initramfs.conf
update-initramfs -u -k all
حالا دوباره بررسی کن:
lsinitramfs /boot/initrd.img-$(uname -r) | grep -E 'virtio_(blk|scsi|net)'روی خانواده RHEL/CentOS/AlmaLinux این معادل با dracut است:
dracut --force --add-drivers "virtio_blk virtio_scsi virtio_net" /boot/initramfs-$(uname -r).imgگام ۴: اصلاح fstab و پارامتر root کرنل
در /etc/fstab هیچ دستگاهی را با نام ثابت نگه ندار. UUID را از blkid بگیر و جایگزین کن. نمونه فایل بعد از اصلاح:
UUID=9f3ac1e2-4b7d-4a11-9c2e-1d8f0a6b3c55  /          ext4  errors=remount-ro  0  1
UUID=1c0a8b77-2e4f-4c2a-8d71-5a6e2f9b0c33  /boot      ext4  defaults           0  2
UUID=4d9e2a10-6b31-4f88-a0c5-7e2b1d9a4f60  none       swap  sw                 0  0
همین UUID را در cmdline کرنل هم تأیید کن:
grep -m1 'root=' /boot/grub/grub.cfg
grep '^GRUB_CMDLINE_LINUX' /etc/default/grub
اگر root=/dev/sda1 دیدی، آن را با root=UUID=... عوض کن و سپس grub را بازتولید کن:
update-grub
# یا در توزیعهایی که update-grub ندارند:
grub-mkconfig -o /boot/grub/grub.cfgگام ۵: اینترفیس شبکه و cloud-init
قواعد udev قدیمی که نام کارت شبکه را به MAC آدرس قبلی گره زدهاند، حذف کن:
rm -f /etc/udev/rules.d/70-persistent-net.rules
rm -f /etc/udev/rules.d/75-persistent-net-generator.rules
فایل netplan قدیمی با IP استاتیک دیتاسنتر قبلی، روی ابر بیمعنی است. آن را با DHCP جایگزین کن:
network:
  version: 2
  ethernets:
    eth0:
      dhcp4: true
      dhcp6: false
اگر نام اینترفیس جدید ens3 است ولی فایل قبلی فقط eth0 را توصیف میکند، یا نام فایل را تغییر بده یا در grub مقدار net.ifnames=0 را به GRUB_CMDLINE_LINUX اضافه کن. بعد از بوت، netplan apply را اجرا کن (داخل chroot معنی ندارد).
در پایان، وضعیت cloud-init را آماده کن تا اینستانس هویت جدید بگیرد:
cloud-init clean --logs
exit
از chroot خارج شو، مانتها را برگردان و در پنل، حالت rescue را غیرفعال کن و اینستانس را روشن کن:
umount -R /mnt/rootبررسی اینکه مشکل واقعاً حل شده است
بعد از بوت موفق، این چکلیست را کامل بزن:
lsmod | grep -E 'virtio_(blk|scsi|net)'
dmesg | grep -i -m3 virtio
findmnt / -o SOURCE,FSTYPE
ip -br address
systemctl --failed
cloud-init status --long
cat /etc/machine-id && hostnamectl- اگر
lsmodماژولvirtio_blkیاvirtio_scsiرا نشان دهد وfindmnt /منبع را/dev/vda*نمایش دهد، بوت از مسیر درست انجام شده است. - خروجی
systemctl --failedباید خالی باشد. خطاهای مربوط به سرویسهای وابسته به IP قدیمی (nginx، postfix، haproxy) معمولاً همینجا خودشان را نشان میدهند. cloud-init status --longبایدstatus: doneباشد؛ اگرerrorداد، datasource درست تشخیص داده نشده و باید/etc/cloud/cloud.cfg.d/را بررسی کنی.- اگر دیسک را بزرگتر کردهای، فقط یک قدم مانده:
growpart /dev/vda 1و سپسresize2fs /dev/vda1(یاxfs_growfs /) و تأیید باdf -h /.
پیشگیری و بهترین روشها
- قبل از مهاجرت، درایورهای virtio را عمداً اضافه کن. یک
MODULES=mostو چند خط در/etc/initramfs-tools/modulesبهاندازه ساعتها عیبیابی شبانه ارزش دارد. - هرگز در fstab و cmdline از نام دستگاه استفاده نکن. UUID یا
LABELتنها مرجع قابل اتکاست؛ نامsdaبین هایپرلایزرها جابهجا میشود. - ایمیج را با ابزار استاندارد تبدیل کن. ابزارهایی مثل
virt-v2vخودشان درایورهای virtio را تزریق و fstab را اصلاح میکنند؛ اکسپورت خام qcow2 بدون این مرحله، همان چیزی است که این مقاله را لازم میکند. - شبکه را DHCP-محور تحویل بده. IP استاتیک را بعد از مهاجرت، از طریق cloud-init یا پنل تخصیص بده، نه داخل ایمیج.
- هویت ماشین را بازتولید کن.
machine-id، کلیدهای SSH هاست و hostname قدیمی روی چند اینستانس همزمان، هم مشکل امنیتی است هم باعث تداخل در مانیتورینگ میشود. - همیشه ابتدا در محیط staging بوت کن. یک اینستانس آزمایشی با همان ایمیج و همان مشخصات شبکه، چند دقیقه وقت میگیرد و کل ریسک را حذف میکند.
مهاجرت ابری در بیشتر مواقع نه با خطای هایپرلایزر، بلکه با این جزئیات کوچک داخل سیستمعامل شکست میخورد؛ همان جاهایی که سالها بدون مشکل کار کردهاند و کسی به آنها نگاه نکرده است.
نویسنده
تیم محتوای کلودیکپ
تیم فنی و محتوای کلودیکپ؛ مهندسانی که هر روز با DevOps، Kubernetes و زیرساخت ابری کار میکنند و تجربههایشان را اینجا مینویسند.
سوالات متداول این مقاله
وضعیت running فقط سالم بودن ماشین مجازی در هایپرلایزر را نشان میدهد. اگر initramfs درایور virtio_blk را نداشته باشد، کرنل دیسک ریشه را پیدا نمیکند و در شل initramfs متوقف میشود؛ در نتیجه sshd هرگز اجرا نمیشود. با کنسول سریال و پیام ALERT! UUID does not exist این وضعیت را تأیید کن.
خیر. اگر کنترلر دیسک ابر از نوع virtio-scsi باشد به virtio_scsi نیاز داری و برای شبکه هم virtio_net. بهترین کار تنظیم MODULES=most و افزودن هر سه ماژول (بههمراه virtio_pci) و سپس اجرای update-initramfs -u -k all است.
چون فایل netplan یا ifcfg از دیتاسنتر قبلی یک IP استاتیک و نام اینترفیس قدیمی (مثلاً eth0) را توصیف میکند، در حالی که کارت شبکه جدید ممکن است ens3 باشد. فایل را به DHCP تغییر بده، قواعد udev قدیمی را حذف کن و در صورت نیاز net.ifnames=0 را به cmdline کرنل اضافه کن.
کلودیکپ در این زمینه چه کمکی میکند؟
مهاجرت به ابر
انتقال ایمن و برنامهریزیشده زیرساخت و برنامهها از سرورهای سنتی به فضای ابری.
مشاهده جزئیات خدمتزیرساخت بهعنوان کد (IaC)
مدیریت زیرساخت بهصورت کد نسخهدار، قابل بازتولید و قابل بازبینی.
مشاهده جزئیات خدمتمعماری زیرساخت ابری
طراحی زیرساخت مقیاسپذیر، امن و مقرونبهصرفه روی AWS، Azure یا Google Cloud.
مشاهده جزئیات خدمت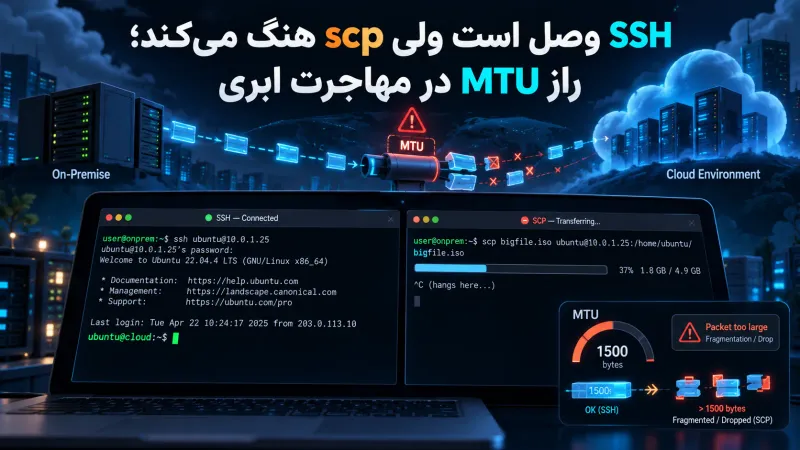
SSH وصل است ولی scp هنگ میکند؛ راز MTU در مهاجرت ابری
بعد از مهاجرت سرور به ابر، SSH وصل میشود اما scp و rsync وسط انتقال هنگ میکنند. ریشه ماجرا MTU کوچکتر شبکه overlay و مسدود بودن ICMP برای PMTUD است.
قفل state ترافورم گیر کرده؛ آزادسازی امن بعد از کیل شدن apply
وقتی پایپلاین CI وسط اجرای apply کشته میشود، قفل state ترافورم در جدول DynamoDB باقی میماند و اجرای بعدی با خطای Error acquiring the state lock متوقف میشود. در این مقاله علت ریشهای، روش آزادسازی امن و راههای پیشگیری را بررسی میکنیم.
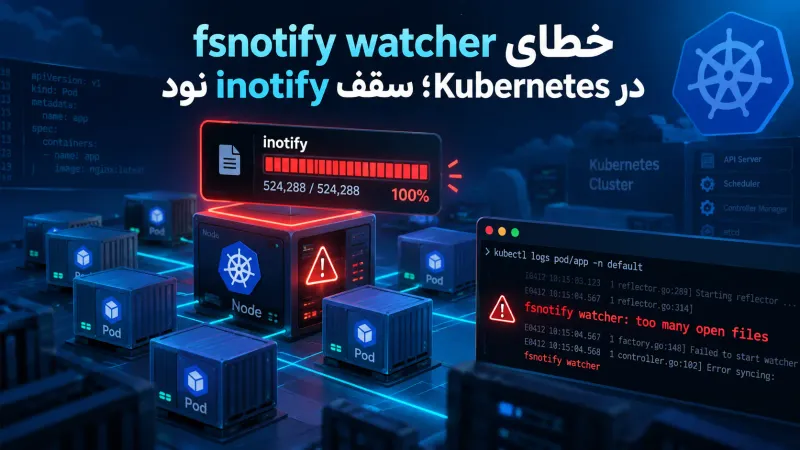
خطای fsnotify watcher در Kubernetes؛ سقف inotify نود
اگر پادهای Grafana، Prometheus یا هر اپلیکیشنی که از inotify استفاده میکند با خطای «failed to create fsnotify watcher: too many open files» کرش میکنند، مقصر سقف پیشفرض هسته لینوکس روی نود است.
در پیادهسازی به کمک نیاز دارید؟
تیم کلودیکپ همین کار را هر روز برای تیمهای دیگر انجام میدهد. اگر جایی گیر کردهاید، با ما صحبت کنید.