خطای fsnotify watcher در Kubernetes؛ سقف inotify نود
اگر پادهای Grafana، Prometheus یا هر اپلیکیشنی که از inotify استفاده میکند با خطای «failed to create fsnotify watcher: too many open files» کرش میکنند، مقصر سقف پیشفرض هسته لینوکس روی نود است.
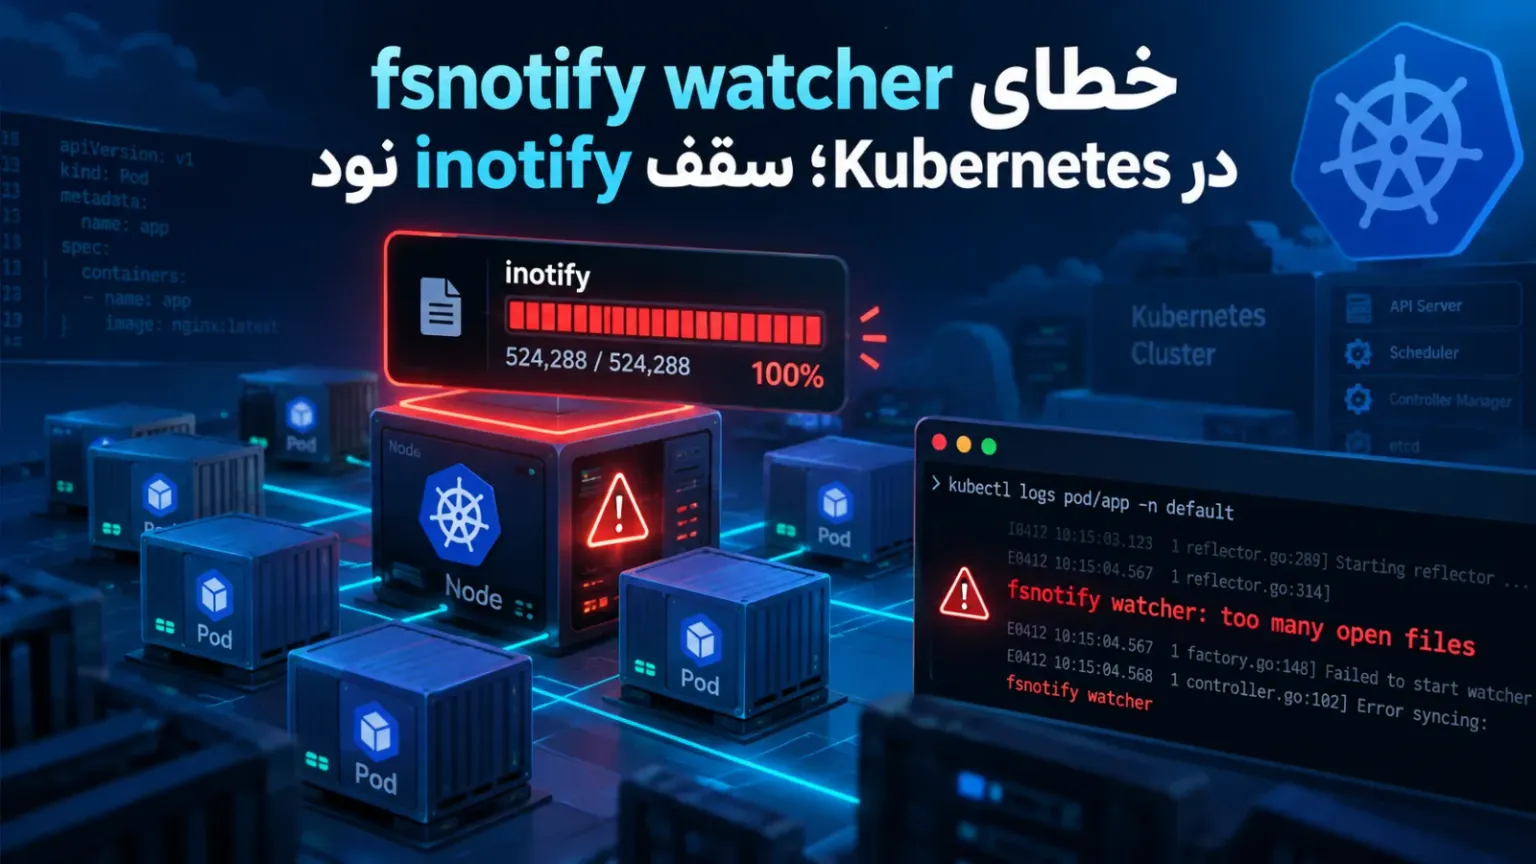
شرح مسئله: کرش پاد با پیام failed to create fsnotify watcher
یکی از سناریوهای پرتکرار در کلاسترهایی که اپهای file-watcher اجرا میکنند، این است که پادها بهشکل ناگهانی به CrashLoopBackOff میافتند یا رولآوت یک Deployment وسط راه گیر میکند. لاگ کانتینر معمولاً چیزی شبیه این نشان میدهد:
level=error msg="failed to create fsnotify watcher: too many open files" logger=ngalert.sender.router
level=error msg="failed to start alertmanager: failed to create fsnotify watcher: too many open files"
نشانههای همراه که معمولاً کنارش دیده میشوند:
- پاد بعد از چند ثانیه کارکرد ریاستارت میشود و
kubectl describe podدلیلErrorیاOOMKilledرا نشان میدهد، در حالی که مصرف حافظه پایین است. - خطای مشابه روی سرویسهای مختلف همان نود تکرار میشود؛ مثلاً همزمان Grafana و Node Exporter و یک اپلیکیشن Node.js.
- بعد از ریاستارت کلاستر یا اضافهکردن چند workload جدید، مشکل تازه ظاهر شده است.
- اگر تعداد پادها را روی همان نود کمتر کنید، مشکل خودبهخود محو میشود — که گمراهکننده است و مهندس را به سمت مشکل منابع (CPU/Memory) میفرستد.
یکی از سردرگمیهای رایج این است که پیام «too many open files» شبیه خطای ulimit -n است، در حالی که اینجا موضوع کاملاً متفاوت است: محدودیت inotify هسته لینوکس، نه file descriptor هر پروسه.
علت ریشهای: سقف inotify هسته، نه منابع پاد
لینوکس برای پشتیبانی از watch کردن فایلها و دایرکتوریها، سه محدودیت per-user دارد که از طریق kernel در اختیار همه پروسهها قرار میگیرد:
| پارامتر | مقدار پیشفرض معمول | کاربرد |
|---|---|---|
fs.inotify.max_user_instances | 128 | تعداد نمونههای inotify که یک کاربر میتواند بسازد |
fs.inotify.max_user_watches | 8192 | تعداد کل watch های فعال یک کاربر |
fs.inotify.max_queued_events | 16384 | صف رویدادهای در انتظار پردازش |
کتابخانههایی مثل fsnotify در Go یا chokidar در Node.js، برای هر watcher یک inotify instance جدا باز میکنند. Grafana وقتی Unified Alerting را روشن میکند، Prometheus برای hot-reload کردن فایل کانفیگ، Java WatchService و بسیاری از سرویسهای دیگر هم همین رفتار را دارند. همه اینها روی نود به یک user (معمولاً root، چون کانتینرها بهطور پیشفرض به همان user namespace نود نگاه میکنند) حساب میشوند.
یعنی وقتی روی یک نود مثلاً ۲۰ پاد file-watcher دارید و هر کدام چند instance میسازد، خیلی سریع به سقف ۱۲۸ میخورید و پروسه بعدی که سعی میکند inotify instance بسازد، با خطای EMFILE و پیام too many open files رد میشود. این سقف توسط Kubernetes مدیریت نمیشود و از ایمیج نود یا توزیع لینوکس ارث میرسد.
راهحل گامبهگام
گام ۱: تأیید مقدار فعلی روی نود
از روی خود نود یا با یک Pod مخصوص تروبلشوتینگ، مقادیر را بخوانید. این مقادیر kernel-global هستند و از داخل کانتینر هم دیده میشوند:
sudo sysctl fs.inotify.max_user_instances fs.inotify.max_user_watches fs.inotify.max_queued_events
# خروجی نمونه
# fs.inotify.max_user_instances = 128
# fs.inotify.max_user_watches = 8192
# fs.inotify.max_queued_events = 16384
برای اطمینان از اینکه مشکل واقعاً همین است، تعداد instance های inotify فعال روی نود را بشمارید. اگر نزدیک سقف یا بالاتر از آن است، تشخیص تأیید میشود:
sudo find /proc/*/fd -lname anon_inode:inotify 2>/dev/null | wc -l
# خروجی نمونه: 124
گام ۲: افزایش موقت برای صحتسنجی سریع
اولین کار، بالا بردن مقدار در حافظه است تا مطمئن شوید مشکل حل میشود. این تغییر با ریاستارت نود از دست میرود:
sudo sysctl -w fs.inotify.max_user_instances=8192
sudo sysctl -w fs.inotify.max_user_watches=524288
sudo sysctl -w fs.inotify.max_queued_events=32768
پادهای مشکلدار را دوباره راهاندازی کنید (با kubectl rollout restart) و لاگها را ببینید. اگر خطا رفت، گام بعدی را برای پایداری انجام دهید.
گام ۳: پایداری روی نود
یک فایل جداگانه در /etc/sysctl.d بسازید تا با هر بوت اعمال شود. مقدار پیشنهادی برای کلاسترهای متوسط و بزرگ:
# /etc/sysctl.d/99-inotify.conf
fs.inotify.max_user_instances = 8192
fs.inotify.max_user_watches = 524288
fs.inotify.max_queued_events = 32768
سپس:
sudo sysctl --system
sudo sysctl fs.inotify.max_user_instances
اگر نودها را با cloud-init، Ansible، Packer یا MachineConfig (در OpenShift) پروویژن میکنید، همین فایل باید بخشی از تصویر پایه نود باشد. برای EKS با Karpenter یا managed node group، از user-data و launch template استفاده کنید.
گام ۴: اعمال cluster-wide با DaemonSet (fallback)
وقتی به دلایلی نمیتوانید ایمیج یا user-data نود را تغییر دهید (مثلاً کلاستر under حمایت تیم زیرساخت دیگری است)، این DaemonSet را با علم به ماهیت privileged آن بهکار ببرید. روی هر نود، sysctl هاست را با nsenter از PID 1 تغییر میدهد:
apiVersion: apps/v1
kind: DaemonSet
metadata:
  name: inotify-tuner
  namespace: kube-system
  labels:
    app.kubernetes.io/name: inotify-tuner
spec:
  selector:
    matchLabels:
      app.kubernetes.io/name: inotify-tuner
  template:
    metadata:
      labels:
        app.kubernetes.io/name: inotify-tuner
    spec:
      hostPID: true
      tolerations:
        - operator: Exists
      initContainers:
        - name: sysctl
          image: alpine:3.20
          securityContext:
            privileged: true
          command:
            - nsenter
            - --target=1
            - --mount
            - --uts
            - --ipc
            - --net
            - --pid
            - --
            - sysctl
            - -w
            - fs.inotify.max_user_instances=8192
            - fs.inotify.max_user_watches=524288
            - fs.inotify.max_queued_events=32768
      containers:
        - name: pause
          image: registry.k8s.io/pause:3.9
نکته مهم: این تغییر هم موقتی است و بعد از ریاستارت نود از بین میرود؛ چون کارش sysctl -w است نه نوشتن در /etc/sysctl.d. برای پایداری واقعی، همان گام ۳ روی ایمیج نود ضروری است و این DaemonSet را فقط بهعنوان پنچر عملیاتی در نظر بگیرید که بعد از هر بوت مجدد باید دوباره اجرا شود (که در واقعیت خودش میتواند منبع دردسر باشد، پس ترجیح دهید حل را در لایه پروویژنینگ نود انجام دهید).
گام ۵: اجرای مجدد workload مشکلدار
kubectl rollout restart deployment/grafana -n monitoring
kubectl rollout status deployment/grafana -n monitoring
بررسی اینکه مشکل واقعاً حل شده است
سه چک سریع، تصویر کامل میدهد:
- مقدار جدید باید از داخل خود پاد هم دیده شود، چون این سقف node-global است:
kubectl exec -it deploy/grafana -n monitoring -- cat /proc/sys/fs/inotify/max_user_instances
# خروجی باید 8192 باشد، نه 128
- در لاگ پاد، پیام
fsnotify watcherنباید دیگر ظاهر شود:
kubectl logs deploy/grafana -n monitoring --since=30m | grep -i fsnotify || echo "OK: no fsnotify errors"
- شمارش تعداد instance های فعال روی نود باید الان بهطور معناداری پایینتر از سقف جدید باشد:
sudo find /proc/*/fd -lname anon_inode:inotify 2>/dev/null | wc -l
# انتظار: عددی در محدوده چند صد، در حالی که سقف 8192 است
اگر خطا برگشت ولی سقف بالا رفته، احتمالاً مشکل از یک اپ با نشتی inotify است؛ در این حالت شمارش per-process را بررسی کنید و ببینید کدام پاد مداوم instance میسازد و رها نمیکند.
پیشگیری و بهترین روشها
- در ایمیج پایه نود بگذارید، نه در runtime. فایل
/etc/sysctl.d/99-inotify.confرا در cloud-init، Packer، AMI پایه یا MachineConfig بگنجانید تا هر نود جدید با تنظیم درست بالا بیاید. - مقدار را بر اساس تعداد پاد پیشبینی کنید. برای هر پاد file-watcher چیزی بین ۵ تا ۲۰ instance در نظر بگیرید و سقف را با ضریب اطمینان بگذارید. برای اکثر کلاسترها
8192برای instance و524288برای watch کافی است. - مصرف را مانیتور کنید. با Node Exporter و یک textfile collector، تعداد instance های فعال را به معیار تبدیل کنید و آلارم روی نسبت به سقف (مثلاً ۷۰٪) بگذارید. آلارم روی «کرش پاد» دیر است؛ باید قبلش متوجه شوید.
- خود اپ را بهینه کنید. اگر Grafana یا هر سرویس دیگری Unified Alerting، hot reload یا file watching ندارد که واقعاً به آن نیاز دارید، غیرفعالش کنید. Prometheus را با
--web.enable-lifecycleو بدون watch روی فایلهای mount شده سنگین بالا نیاورید. - محدودیت را در سمت بار کاری هم در نظر بگیرید. قید
securityContext.runAsUserبا UID متفاوت برای اپهای پرحجم، سهمیهی inotify را از root جدا میکند و از برخورد منابع در یک نود جلوگیری میکند. - مستند کنید. این تنظیم را بهعنوان بخشی از «baseline نود» در runbook تیم نگه دارید تا هر کسی که کلاستر جدید میسازد آن را لحاظ کند؛ در غیر اینصورت مشکل چند ماه بعد در محیط production دوباره سر باز میکند.
خطای fsnotify watcher در نگاه اول شبیه یک باگ اپلیکیشنی بهنظر میرسد، اما در واقع یک تنظیم فراموششده در لایه نود است. با بالا بردن سقف inotify در پروویژن نود و مانیتور کردن مصرف، این دسته از کرشها را برای همیشه از سبد تیکتهای عملیاتی حذف میکنید.
نویسنده
تیم محتوای کلودیکپ
تیم فنی و محتوای کلودیکپ؛ مهندسانی که هر روز با DevOps، Kubernetes و زیرساخت ابری کار میکنند و تجربههایشان را اینجا مینویسند.
سوالات متداول این مقاله
متن «too many open files» معمولاً مهندس را به سمت ulimit و file descriptor هر پروسه میبرد، اما این خطا در واقع از سقف inotify هسته لینوکس میآید که per-user (معمولاً root) است و بین همه پادهای روی همان نود مشترک است. بالا بردن limit پاد یا CPU/Memory بیفایده است.
هر watch در هسته چیزی در حدود یک کیلوبایت اشغال میکند؛ پس ۵۲۴۲۸۸ watch حدود چند صد مگابایت سقف مصرف دارد. چون این سقف است نه تخصیص، حافظه فقط در صورت استفاده واقعی مصرف میشود. برای اکثر کلاسترها بین ۱۲۸ تا ۵۱۲ هزار watch کاملاً امن است.
چون آن DaemonSet با sysctl -w مقدار را فقط در حافظه هسته اعمال میکند و در فایل پیکربندی نمینویسد. برای پایداری باید فایل /etc/sysctl.d روی ایمیج نود یا در cloud-init قرار بگیرد تا با هر بوت اعمال شود.
کلودیکپ در این زمینه چه کمکی میکند؟
مشاوره DevOps
ارزیابی فرآیندهای فعلی توسعه و عملیات و طراحی نقشهراه فنی متناسب با اهداف کسبوکار شما.
مشاهده جزئیات خدمتKubernetes و مدیریت کانتینر
استقرار، پیکربندی و نگهداری خوشههای Kubernetes برای اجرای مقیاسپذیر برنامهها.
مشاهده جزئیات خدمتمعماری زیرساخت ابری
طراحی زیرساخت مقیاسپذیر، امن و مقرونبهصرفه روی AWS، Azure یا Google Cloud.
مشاهده جزئیات خدمت
تأخیر ۵ ثانیهای DNS در Kubernetes؛ پای ndots:5 در میان است
هرچند وقت یکبار یک درخواست خروجی دقیقاً ۵ ثانیه طول میکشد و بعد موفق میشود؟ ریشه معمولاً گزینه ndots:5 در resolv.conf پادها و لیست search است. این مقاله علت، تشخیص و راهحل کامل را بررسی میکند.
پاد Kubernetes در وضعیت Terminating گیر کرده؛ آزادسازی امن
پاد در حالت Terminating گیر کرده و با kubectl delete پاک نمیشود؟ این مقاله علت واقعی (finalizer باقیمانده، نود NotReady، ولوم گیرکرده) و راهحل گامبهگام امن را نشان میدهد.
قطع شدن WebSocket در HAProxy هر ۵۰ ثانیه؛ علت و راهحل
اگر WebSocket یا SSE پشت HAProxy هر ۵۰ ثانیه قطع میشود، مقصر تایماوتهای پیشفرض فایل نمونه است. در این مقاله علت ریشهای و پیکربندی درست timeout tunnel را بررسی میکنیم.
در پیادهسازی به کمک نیاز دارید؟
تیم کلودیکپ همین کار را هر روز برای تیمهای دیگر انجام میدهد. اگر جایی گیر کردهاید، با ما صحبت کنید.