رفع خطای 429 در Trivy DB با راهاندازی mirror داخلی
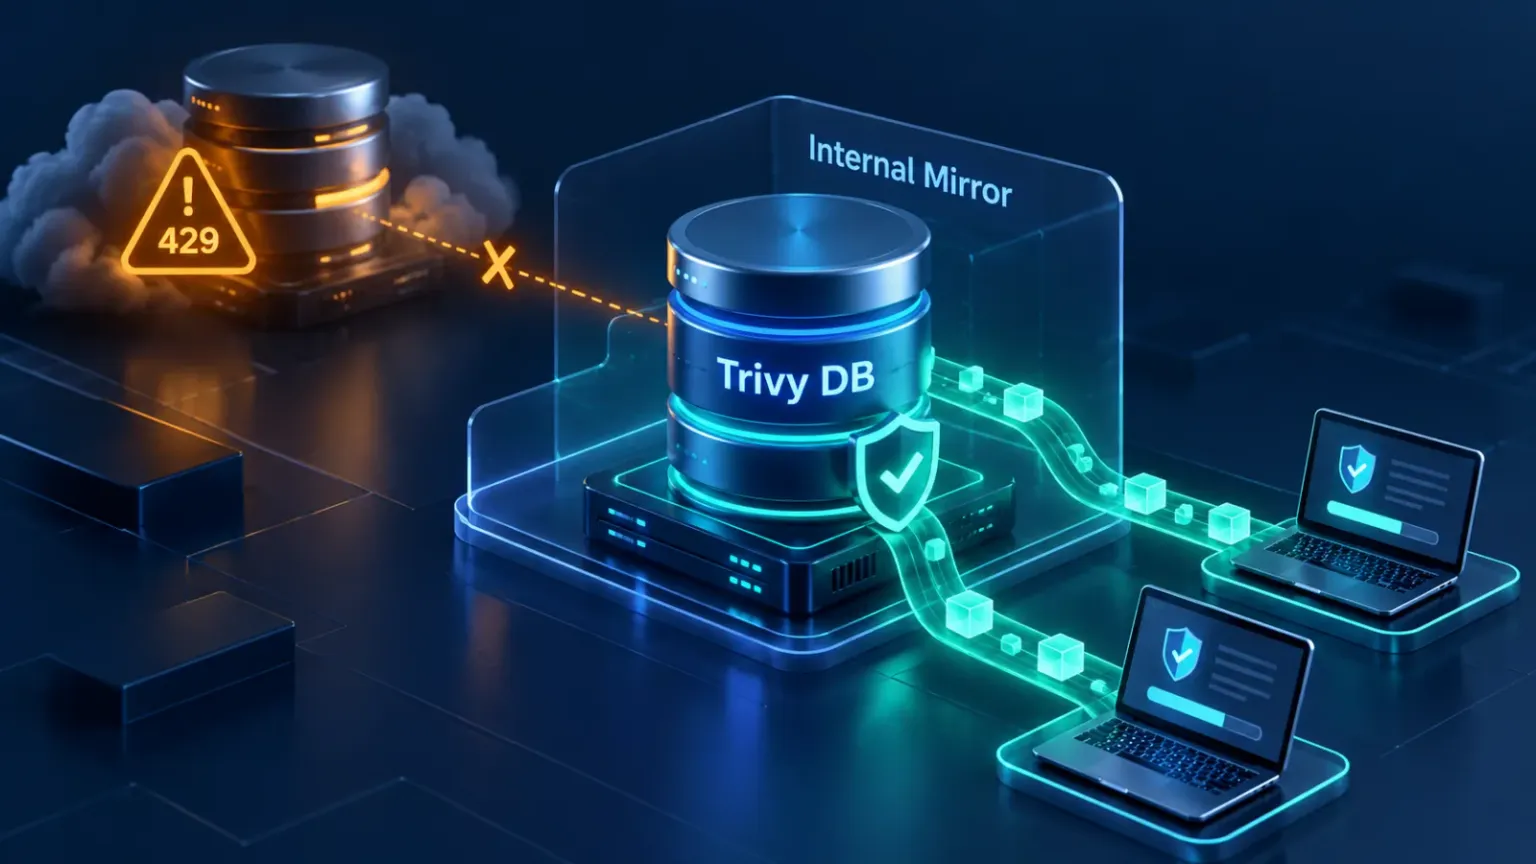
اگر مرحله اسکن Trivy در پایپلاین با خطای 429 Too Many Requests شکست میخورد، مشکل از کد یا شبکه شما نیست؛ GHCR نرخ pull ناشناس را محدود میکند. در این مقاله پایگاهداده Trivy را در رجیستری داخلی mirror میکنیم و Trivy را به آن وصل میکنیم.
شرح مسئله
جاب اسکن امنیتی که ماهها سبز بود، یکدفعه قرمز میشود و لاگ Trivy چیزی شبیه این نشان میدهد:
2025-01-14T09:12:41Z FATAL Fatal error run error: init error: DB error: failed to download vulnerability DB: database download error: OCI repository error: 1 error occurred:
    * failed to download artifact: failed to copy: httpReadSeeker: failed open: unexpected status code https://ghcr.io/v2/aquasecurity/trivy-db/blobs/sha256:9d1...: 429 Too Many Requests
قبل از اینکه به سمت شبکه، DNS یا پروکسی شرکت بروید، به این نشانهها دقت کنید:
خطا قطعی نیست: بعضی اجراها سبز است، بعضی قرمز. یک rerun ساده معمولاً جواب میدهد و همین باعث میشود مشکل جدی گرفته نشود.
روی لپتاپ خودتان همان دستور بدون خطا اجرا میشود، ولی روی runnerهای CI نه.
مرحله اسکن کند است: هر اجرا چند دقیقه صرف دانلود پایگاهداده میشود، حتی وقتی ایمیج کش شده است.
خطا در فاز
initرخ میدهد؛ یعنی Trivy حتی به اسکن ایمیج نرسیده و پایپلاین بدون هیچ یافته امنیتی شکست خورده است.
نکته مهم این است که این خطا false positive نیست؛ پایپلاین واقعاً اسکن نشده و شما در آن لحظه هیچ سیگنال امنیتی از ایمیج ندارید. بدترین واکنش، حذف یا allow_failure کردن جاب است.
علت ریشهای
Trivy پایگاهداده آسیبپذیریها را بهصورت یک artifact از نوع OCI نگه میدارد و بهطور پیشفرض آن را از GHCR میگیرد:
پایگاهداده اصلی:
ghcr.io/aquasecurity/trivy-db:2پایگاهداده مخازن Java:
ghcr.io/aquasecurity/trivy-java-db:1
GHCR برای pull ناشناس (بدون احراز هویت) نرخمحدودیت اعمال میکند و این محدودیت بر اساس IP است. در محیط عملیاتی سه چیز دستبهدست هم میدهند و شما را به سقف میرسانند:
IP مشترک خروجی: همه runnerها از پشت یک NAT یا یک IP ثابت شرکت بیرون میروند؛ پس سهمیه شما با سهمیه کل سازمان جمع میشود.
موازیسازی: چند پایپلاین همزمان روی چند برنچ، یا چند جاب در یک stage، همزمان درخواست دانلود میدهند و نرخ لحظهای را منفجر میکنند.
نبود کش: runnerهای ephemeral هیچ چیز را بین اجراها نگه نمیدارند. Trivy در هر اجرا ابتدا manifest مخزن را چک میکند تا ببیند DB عوض شده یا نه؛ همان چک هم یک درخواست به GHCR است و به سهمیه شما اضافه میشود. اگر دایجست عوض شده باشد، دانلود کامل هم اضافه میشود.
خلاصه: این یک باگ در کد شما یا یک مشکل گذرای شبکه نیست؛ یک وابستگی معماری به یک رجیستری عمومی با نرخمحدودیت است. راهحل درست، حذف این وابستگی است، نه retry کردن آن.
راهحل گامبهگام
گام ۰: تأیید اینکه خطا واقعاً ۴۲۹ است
قبل از هر تغییری، مطمئن شوید خطا از نرخمحدودیت میآید و نه از timeout پروکسی یا خطای TLS:
trivy image --debug python:3.11-slim 2>&1 | grep -i -E "429|too many requests|rate"
اگر خروجی خالی بود، مشکل جای دیگری است و ادامه این مقاله کمکی نمیکند.
گام ۱: mirror کردن پایگاهداده در رجیستری داخلی
برای جابهجایی artifactهای OCI از ابزار oras استفاده میکنیم. یک کاربر با دسترسی push روی رجیستری داخلی بسازید و اسکریپت زیر را روی یک ماشین با اینترنت آزاد (مثلاً سرور mirror) قرار دهید:
#!/usr/bin/env bash
# /usr/local/bin/trivy-db-mirror.sh
set -euo pipefail

REGISTRY="registry.example.com"
SRC_DB="ghcr.io/aquasecurity/trivy-db:2"
DST_DB="${REGISTRY}/security/trivy-db:2"
SRC_JAVA="ghcr.io/aquasecurity/trivy-java-db:1"
DST_JAVA="${REGISTRY}/security/trivy-java-db:1"

printf '%s' "$REGISTRY_PASSWORD" | oras login "$REGISTRY" \
  --username "$REGISTRY_USER" --password-stdin

oras cp "$SRC_DB"   "$DST_DB"
oras cp "$SRC_JAVA" "$DST_JAVA"

echo "$(date -Is) trivy db mirror ok"
دو نکته عملی:
اگر
oras cpبا خطای platform شکست خورد، فلگ--platform linux/amd64را اضافه کنید؛ این artifactها شامل چند پلتفرم نیستند ولی ابزار گاهی سختگیر میشود.رجیستری داخلی باید OCI-conformant باشد. Harbor، Nexus و GitLab Container Registry همه گزینههای خوبیاند. اگر Harbor دارید، بهجای این اسکریپت میتوانید proxy cache بسازید و
--db-repositoryرا به همان پروژه اشاره دهید.
سپس با cron روزانه sync را اجرا کنید:
# /etc/cron.d/trivy-db-mirror
15 2 * * * root /usr/local/bin/trivy-db-mirror.sh >> /var/log/trivy-db-mirror.log 2>&1
دقت کنید که پارامتر REGISTRY_PASSWORD را از یک فایل با مجوز 600 یا از secret manager بخوانید، نه داخل خود اسکریپت.
گام ۲: وصل کردن Trivy به mirror
Trivy هم با فلگ و هم با متغیر محیطی این آدرس را قبول میکند. در GitLab CI:
variables:
  TRIVY_DB_REPOSITORY: "registry.example.com/security/trivy-db:2"
  TRIVY_JAVA_DB_REPOSITORY: "registry.example.com/security/trivy-java-db:1"
  TRIVY_CACHE_DIR: "$CI_PROJECT_DIR/.trivy-cache"
  TRIVY_USERNAME: "$REGISTRY_USER"
  TRIVY_PASSWORD: "$REGISTRY_PASSWORD"

trivy-scan:
  stage: security
  image:
    name: aquasec/trivy:0.58.1
    entrypoint: [""]
  cache:
    key: trivy-db
    paths:
      - .trivy-cache/
  script:
    - >
      trivy image
      --cache-dir "$TRIVY_CACHE_DIR"
      --scanners vuln
      --severity CRITICAL,HIGH
      --ignore-unfixed
      --exit-code 1
      --format table
      "$CI_REGISTRY_IMAGE:$CI_COMMIT_SHA"
متغیرهای REGISTRY_USER و REGISTRY_PASSWORD را در تنظیمات CI تعریف و masked کنید. توکن فقط به pull نیاز دارد؛ دسترسی نوشتن به هیچ پایپلاینی داده نشود. اگر رجیستری داخلی شما روی همان شبکه runnerها و بدون احراز هویت باز است، این دو متغیر را حذف کنید.
گام ۳: کش کردن پایگاهداده
با TRIVY_CACHE_DIR، Trivy دیتابیس را یک بار میگیرد و اجراهای بعدی فقط دایجست را چک میکنند. دو حالت داریم:
runner با دیسک پایدار: مقدار
TRIVY_CACHE_DIRرا به یک مسیر دائمی مثل/var/cache/trivyبدهید. بهترین حالت همین است؛ سریع و بدون آرشیو کردن.runner ephemeral: از
cacheخود CI استفاده کنید. توجه کنید که GitLab در هر جاب آرشیو را دانلود و باز میکند؛ یک DB چند صد مگابایتی روی شبکه داخلی سریع است ولی بیهزینه نیست.
گام ۴: محیط بدون اینترنت
برای runnerهای air-gapped، کش را از بیرون منتقل میکنید و از Trivy میخواهید به هیچ رجیستریای دست نزند:
# روی ماشین متصل: کش را گرم کن
mkdir -p /opt/trivy-cache
trivy image --cache-dir /opt/trivy-cache alpine:3.19
tar -czf trivy-cache.tgz -C /opt/trivy-cache .
# روی ماشین ایزوله: بازگردانی و استفاده بدون بهروزرسانی
tar -xzf trivy-cache.tgz -C /opt/trivy-cache
trivy image --cache-dir /opt/trivy-cache \
--skip-db-update --skip-java-db-update alpine:3.19
اینجا پایگاهداده در زمان اجرا بهروز نمیشود، پس تاریخچه انتقال فایل کش بخشی از فرایند عملیاتی شماست. بدون آن، در عمل روی یک DB ماهها قدیمی اسکن میکنید.
بررسی اینکه مشکل واقعاً حل شده است
سه تست زیر را اجرا کنید؛ هر سه باید پاس شوند:
# ۱) آیا Trivy واقعاً از رجیستری ما میخواند؟
# مخزن عمداً اشتباه بدهید؛ خطا باید آدرس رجیستری خودتان را نشان بدهد
# و هیچ fallback ای به ghcr.io رخ ندهد.
trivy image --cache-dir /tmp/trivy-verify \
--db-repository registry.example.com/security/does-not-exist:2 \
alpine:3.19
# ۲) اجرای دوم باید سریع و بدون دانلود باشد
time trivy image --cache-dir /tmp/trivy-verify alpine:3.19
time trivy image --cache-dir /tmp/trivy-verify alpine:3.19
# ۳) دایجست mirror و منبع اصلی باید یکی باشد
oras manifest fetch registry.example.com/security/trivy-db:2 --descriptor | jq -r '.digest'
oras manifest fetch ghcr.io/aquasecurity/trivy-db:2 --descriptor | jq -r '.digest'
علاوه بر این، یک تست کاربردیتر بزنید: تعداد یافتههای اسکن قبل و بعد از مهاجرت باید یکسان باشد. اگر mirror ناقص sync شده باشد، Trivy ممکن است بدون خطا با DB ناقص اسکن کند و شما متوجه نشوید:
trivy image --format json --output before.json myapp:1.0
# بعد از تغییر تنظیمات و پاک کردن کش
trivy image --format json --output after.json myapp:1.0
jq '[.Results[].Vulnerabilities[]?] | length' before.json
jq '[.Results[].Vulnerabilities[]?] | length' after.json
در نهایت، لاگ دسترسی رجیستری داخلی را ببینید: باید از هر runner بهطور منظم درخواست pull ثبت شده باشد و از سمت GHCR تقریباً هیچ ترافیکی نباشد.
پیشگیری و بهترین روشها
همه artifactهای خارجی را mirror کنید: فقط DB آسیبپذیری نیست؛ ایمیجهای پایه، chartهای Helm و مخازن بستهها هم همین رفتار را دارند. یک سیاست egress بگذارید که خروج به
ghcr.ioوdocker.ioرا از سمت runnerها ببندد تا وابستگی پنهان دوباره ساخته نشود.پیامد شکست sync را جدی بگیرید: اگر cron شبانه شکست بخورد، پایپلاینها همچنان سبز میمانند و کسی متوجه نمیشود. روی نتیجه اسکریپت mirror alert بگذارید و سن آخرین sync را در داشبورد نشان بدهید.
fail-closed رفتار کنید: اگر DB در دسترس نبود، جاب اسکن باید شکست بخورد، نه اینکه با «بدون یافته» تمام شود. اسکن نکردن را هرگز با پاس شدن برابر نگیرید.
دیتابیس را بیش از حد قدیمی نگه ندارید: یک DB دو هفته قدیمی یعنی CVEهای جدید در گزارش شما نیستند. سن پایگاهداده را پایش کنید و sync را حداقل روزانه اجرا کنید.
موازیسازی را کنترل کنید: اگر چند جاب همزمان اسکن میکنند، یک جاب مقدماتی دیتابیس را در کش مشترک آماده کند و بقیه فقط مصرف کنند.
آستانهها را واقعبینانه بگذارید: استفاده از
--ignore-unfixedو آستانهCRITICAL,HIGHباعث میشود تیم اسکن را جدی بگیرد. گیتهایی که هر اجرا قرمز میشوند، دیر یا زود باallow_failureخاموش میشوند و همان کار را خراب میکنند.نسخه Trivy را pin کنید: ارتقای ناگهانی نسخه اسکنر میتواند رفتار گزارش و فرمت خروجی را عوض کند؛ نسخه را در ایمیج CI ثابت و ارتقا را آگاهانه انجام دهید.
پرسشهای پرتکرار
چرا خطا فقط بعضی وقتها رخ میدهد؟
چون نرخمحدودیت پنجرهای است و به IP شما وابسته است. هر موازیسازی در پایپلاین یا هر تیم دیگری که از همان IP خروجی استفاده میکند، سهمیه شما را مصرف میکند. به همین دلیل retry دادن گاهی جواب میدهد و این توهم را ایجاد میکند که مشکل گذرا بوده است.
آیا احراز هویت با توکن GitHub مشکل را حل نمیکند؟
سهمیه بالاتری میدهد و بهعنوان مسکن کار میکند، ولی وابستگی شما به یک سرویس خارجی و به یک توکن باقی میماند و در محیط با اینترنت محدود یا air-gapped کار نمیکند. راهحل پایدار همان mirror داخلی است.
آیا میتوانم دیتابیس را داخل ایمیج CI بگذارم؟
فنی است ولی توصیه نمیشود؛ پایگاهداده روزانه بهروز میشود و شما با هر sync باید ایمیج بسازید و منتشر کنید. کش کردن روی دیسک پایدار runner یا mirror در رجیستری، چرخه بهروزرسانی را بسیار سادهتر میکند.
نویسنده
تیم محتوای کلودیکپ
تیم فنی و محتوای کلودیکپ؛ مهندسانی که هر روز با DevOps، Kubernetes و زیرساخت ابری کار میکنند و تجربههایشان را اینجا مینویسند.
سوالات متداول این مقاله
چون نرخمحدودیت GHCR پنجرهای و بر اساس IP است. تمام runnerهایی که از پشت یک NAT بیرون میروند سهمیه مشترک دارند و هر موازیسازی در پایپلاین یا هر تیم دیگری روی همان IP، سهمیه شما را مصرف میکند. به همین دلیل rerun گاهی سبز میشود و مشکل بهنظر گذرا میآید.
سهمیه pull بالاتری میدهد و بهعنوان راهحل موقت قابل قبول است، ولی وابستگی به ghcr.io و به یک توکن باقی میماند و روی runnerهای بدون اینترنت کار نمیکند. راهحل پایدار، mirror trivy-db در رجیستری داخلی و تنظیم TRIVY_DB_REPOSITORY است.
اسکن با همان نسخه قدیمی انجام میشود و ممکن است CVEهای تازهمنتشرشده در گزارش نیایند؛ خطایی هم دریافت نمیکنید. بنابراین sync شبانه باید alert داشته باشد و سن آخرین بهروزرسانی پایگاهداده در داشبورد پایش شود.
کلودیکپ در این زمینه چه کمکی میکند؟
معماری زیرساخت ابری
طراحی زیرساخت مقیاسپذیر، امن و مقرونبهصرفه روی AWS، Azure یا Google Cloud.
مشاهده جزئیات خدمتمشاوره DevOps
ارزیابی فرآیندهای فعلی توسعه و عملیات و طراحی نقشهراه فنی متناسب با اهداف کسبوکار شما.
مشاهده جزئیات خدمتمهاجرت به ابر
انتقال ایمن و برنامهریزیشده زیرساخت و برنامهها از سرورهای سنتی به فضای ابری.
مشاهده جزئیات خدمت
چرا همگامسازی JQL در Jira فقط ۵۰ ایشو برمیگرداند؟
اگر job همگامسازی Jira شما بدون خطا تمام میشود ولی فقط ۵۰ ایشو را میآورد یا در حلقه بیپایان گیر میکند، مشکل از JQL نیست؛ اندپوینت search به pagination مبتنی بر nextPageToken منتقل شده و startAt و total دیگر وجود ندارند.
قفل state ترافورم گیر کرده؛ آزادسازی امن بعد از کیل شدن apply
وقتی پایپلاین CI وسط اجرای apply کشته میشود، قفل state ترافورم در جدول DynamoDB باقی میماند و اجرای بعدی با خطای Error acquiring the state lock متوقف میشود. در این مقاله علت ریشهای، روش آزادسازی امن و راههای پیشگیری را بررسی میکنیم.
پاد Kubernetes در وضعیت Terminating گیر کرده؛ آزادسازی امن
پاد در حالت Terminating گیر کرده و با kubectl delete پاک نمیشود؟ این مقاله علت واقعی (finalizer باقیمانده، نود NotReady، ولوم گیرکرده) و راهحل گامبهگام امن را نشان میدهد.
در پیادهسازی به کمک نیاز دارید؟
تیم کلودیکپ همین کار را هر روز برای تیمهای دیگر انجام میدهد. اگر جایی گیر کردهاید، با ما صحبت کنید.