تأخیر ۵ ثانیهای DNS در Kubernetes؛ پای ndots:5 در میان است
هرچند وقت یکبار یک درخواست خروجی دقیقاً ۵ ثانیه طول میکشد و بعد موفق میشود؟ ریشه معمولاً گزینه ndots:5 در resolv.conf پادها و لیست search است. این مقاله علت، تشخیص و راهحل کامل را بررسی میکند.
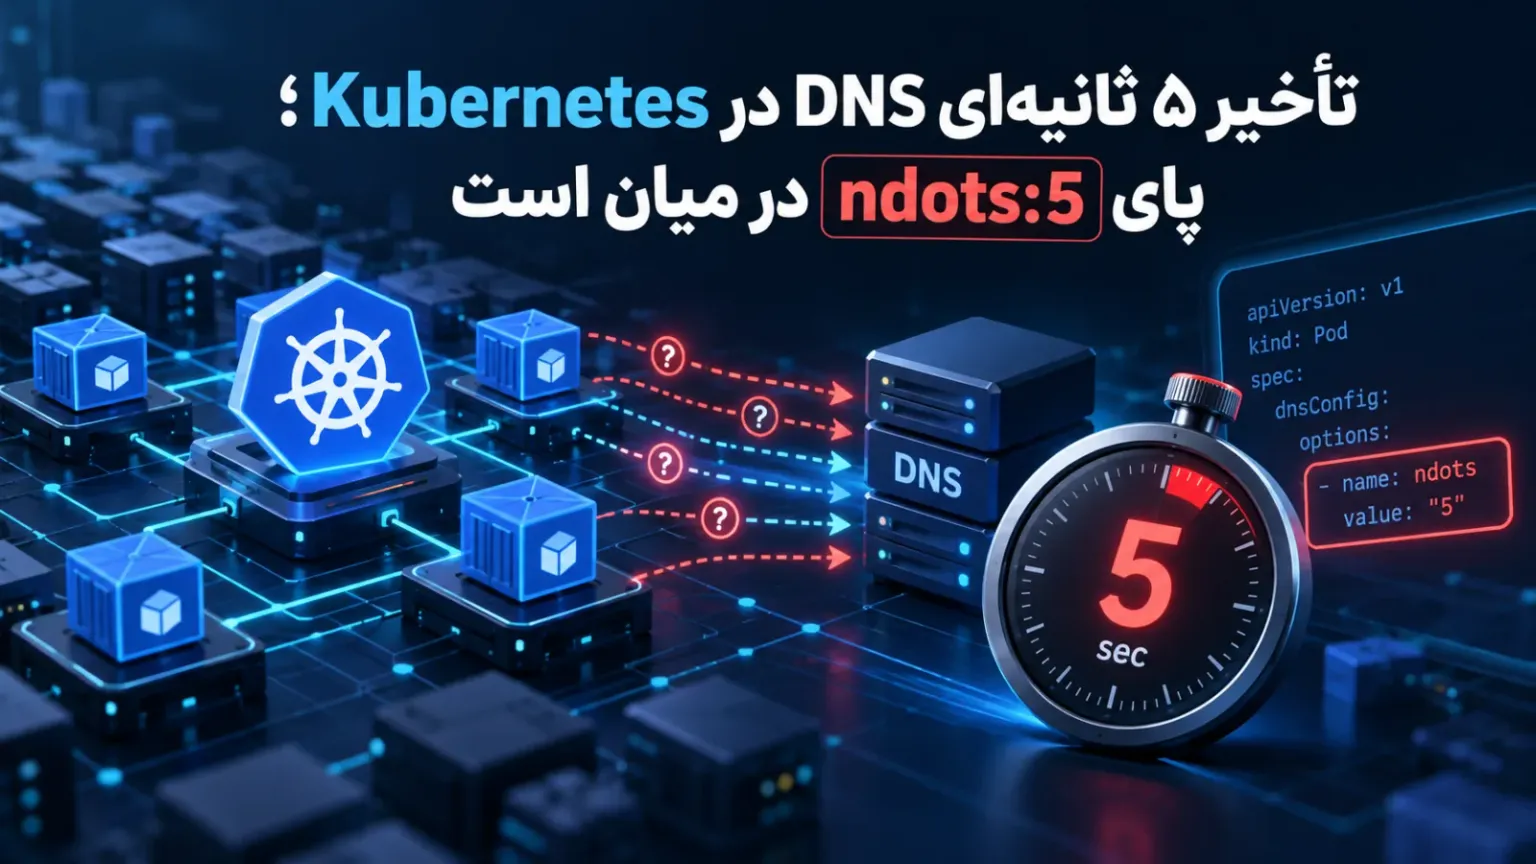
اگر مدتی با Kubernetes کار کرده باشید، حتماً این صحنه را دیدهاید: سرویسی که بیشتر اوقات سالم است، اما هر چند وقت یکبار یک درخواست خروجی دقیقاً حدود ۵ ثانیه طول میکشد و بعد موفق میشود. نه CPU اشباع است، نه شبکه، و نه سرویس مقصد مشکل دارد. ردپای این الگوی ۵ ثانیهای تقریباً همیشه به DNS و گزینه ndots:5 در /etc/resolv.conf پادها میرسد.
شرح مسئله: تأخیری که پترن مشخصی دارد
نشانههای کلاسیک این مشکل را میتوان در چند جا دید:
- در لاگ اپلیکیشن، خطاهایی مثل
context deadline exceeded،dial tcp: i/o timeoutیاlookup api.example.com: i/o timeoutکه بعد از ۵ ثانیه با یک retry موفق میشوند. - تأخیر فقط برای نامهای خارج از کلاستر دیده میشود؛ سرویسهای داخلی سریع پاسخ میدهند.
- افزایش ناگهانی نرخ کوئری CoreDNS و بالا رفتن شمارنده پاسخهای
NXDOMAIN. - مصرف CPU کوردیاناس بهازای هر Request Per Second بیشتر از حد انتظار.
- گاهی تأخیر فقط روی اولین درخواست یا بعد از یک دوره بیکاری دیده میشود.
همین «۵ ثانیه ثابت» مهمترین سرنخ است؛ چون یک عدد تصادفی نیست و به تایمر پیشفرض resolver برمیگردد.
علت ریشهای: ndots:5 و لیست search
وقتی پادی با dnsPolicy: ClusterFirst اجرا میشود، kubelet یک /etc/resolv.conf با این شکل میسازد:
nameserver 10.96.0.10
search default.svc.cluster.local svc.cluster.local cluster.local
options ndots:5
معنای ndots این است: اگر تعداد نقطههای یک نام کمتر از این مقدار باشد، resolver ابتدا نام را با هر یک از دامنههای search میآزماید و تنها در انتها نسخه مطلق (absolute) را میپرسد. چون ndots روی ۵ تنظیم شده و تقریباً هیچ نامی ۵ نقطه ندارد، عملاً همه نامها از مسیر search رد میشوند.
نتیجه برای api.stripe.com این ترتیب میشود:
api.stripe.com.default.svc.cluster.local← NXDOMAINapi.stripe.com.svc.cluster.local← NXDOMAINapi.stripe.com.cluster.local← NXDOMAINapi.stripe.com← پاسخ درست
و چون برای هر نام هم رکورد A و هم AAAA پرسیده میشود، یک lookup ساده به ۸ کوئری تبدیل میشود. این هم glibc (سیستمی) و هم resolver خالص Go مصداق دارد.
حالا نکته کلیدی: فایل resolv.conf مقدار timeout را تنظیم نمیکند، پس پیشفرض یعنی timeout:5 اعمال میشود. هر بسته UDP که گم شود یا دیر برسد — بهخاطر race کانترک UDP در kube-proxy، اشباع CoreDNS، یا NetworkPolicy — باعث میشود resolver پنج ثانیه منتظر بماند و بعد retry کند. با ۸ کوئری بهجای ۲ کوئری، احتمال برخورد با این شرط عملاً چهار برابر میشود. اینجاست که «معماری ndots:5» و «۵ ثانیه» به هم میرسند.
گام ۱: بازتولید و تشخیص
یک پاد موقت با ابزارهای شبکه بالا بیاورید:
kubectl run tmp-dns --image=nicolaka/netshoot --restart=Never --command -- sleep 3600
kubectl exec -it tmp-dns -- cat /etc/resolv.conf
باید خط options ndots:5 را ببینید. حالا کوئریها را با tcpdump بشمارید تا ترتیب واقعی را ببینید:
kubectl exec -it tmp-dns -- tcpdump -i any -n port 53
در یک ترمینال دیگر یک lookup خارجی انجام دهید:
kubectl exec -it tmp-dns -- dig +search +stats api.stripe.com
خروجی tcpdump چیزی شبیه این است:
10.244.1.7.52341 > 10.96.0.10.53: A? api.stripe.com.default.svc.cluster.local. (58)
10.96.0.10.53 > 10.244.1.7.52341: NXDomain 0/1/0 (137)
10.244.1.7.52341 > 10.96.0.10.53: AAAA? api.stripe.com.default.svc.cluster.local. (58)
10.96.0.10.53 > 10.244.1.7.52341: NXDomain 0/1/0 (137)
...
اگر ترافیک کلاستر شما بزرگ است، بهترین معیار، متریک خود CoreDNS است:
kubectl -n kube-system logs -l k8s-app=kube-dns --tail=50
و در Prometheus نرخ پاسخهای منفی را ببینید:
sum(rate(coredns_dns_responses_total{rcode="NXDOMAIN"}[5m]))
گام ۲: تنظیم ndots با dnsConfig
سادهترین و مؤثرترین راه، تغییر ndots در سطح پاد است. بدون نیاز به دست زدن به CoreDNS:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: api
spec:
  replicas: 3
  selector:
    matchLabels:
      app: api
  template:
    metadata:
      labels:
        app: api
    spec:
      dnsPolicy: ClusterFirst
      dnsConfig:
        options:
          - name: ndots
            value: "2"
          - name: timeout
            value: "1"
          - name: attempts
            value: "3"
      containers:
        - name: api
          image: example/api:1.0
          ports:
            - containerPort: 8080
انتخاب عدد ndots یکtrade-off است:
- ndots: 2 گزینه متعادل و پیشنهادی است. نامهایی مثل
api.stripe.com(دو نقطه) مستقیم مطلق پرسیده میشوند و نامهای داخلی کوتاه مثلredisیاmy-svc.my-nsهمچنان از search استفاده میکنند. - ndots: 1 برای workloadهایی که تقریباً همیشه با دامنههای خارجی حرف میزنند مناسب است و کمترین تعداد کوئری را تولید میکند.
- ndots: 5 پیشفرض را فقط برای اپلیکیشنهایی نگه دارید که عمدتاً نامهای کوتاه تکبرچسبی داخل کلاستر را resolve میکنند.
کاهش timeout به ۱ ثانیه هم مهم است: در صورت گم شدن بسته، بهجای ۵ ثانیه انتظار، سریعتر retry میشود. مقدار attempts بالاتر، پوشش خطا را حفظ میکند.
راه مکمل: در کد یا کانفیگ اپلیکیشن، برای مسیرهای داغ از FQDN با نقطه پایانی استفاده کنید (api.stripe.com.). نقطه انتهایی به resolver میگوید این نام مطلق است و لیست search کاملاً دور زده میشود.
گام ۳: NodeLocal DNSCache برای کلاسترهای بزرگ
تنظیم ndots تعداد کوئریها را کم میکند، اما race کانترک UDP را حل نمیکند. اگر تعداد پادها بالاست یا از kube-proxy با iptables استفاده میکنید، NodeLocal DNSCache را در نظر بگیرید: یک listener محلی روی هر نود که کوئریها را قبل از عبور از iptables میگیرد و کَش میکند.
# ClusterIP سرویس DNS کلاستر
kubectl -n kube-system get svc kube-dns -o jsonpath='{.spec.clusterIP}'
مانیفست رسمی nodelocaldns.yaml را دریافت کنید، مقدار __POD_IP__ را با IP محلی (معمولاً 169.254.25.10) جایگزین کنید و مطمئن شوید هدف forward در Corefile همان ClusterIP سرویس kube-dns است. سپس پکیج لازم را روی نودها نصب و اپلای کنید:
sed -i 's/__POD_IP__/169.254.25.10/g' nodelocaldns.yaml
kubectl apply -f nodelocaldns.yaml
kubectl -n kube-system get pods -l k8s-app=node-local-dns -o wide
در نهایت مقدار --cluster-dns را در kubelet روی هر نود به 169.254.25.10 تغییر دهید و kubelet را ریاستارت کنید تا پادهای جدید به listener محلی اشاره کنند. بعد از این تغییر، پاسخهای گمشده UDP تقریباً به صفر میرسد.
گام ۴: بهینهسازی CoreDNS
حتی بعد از تنظیم ndots، CoreDNS باید بار را راحت تحمل کند. ConfigMap را ویرایش کنید:
.:53 {
    errors
    health {
       lameduck 5s
    }
    ready
    kubernetes cluster.local in-addr.arpa ip6.arpa {
       pods insecure
       fallthrough in-addr.arpa ip6.arpa
       ttl 30
    }
    prometheus :9153
    forward . /etc/resolv.conf {
       max_concurrent 1000
    }
    cache 30 {
       success 65536 30
       denial 65536 5
    }
    loop
    reload
    loadbalance
}
دو نکته مهم: بخش denial در پلاگین cache پاسخهای NXDOMAIN پرتکرار را ۵ ثانیه کَش میکند و بار روی upstream را بهشدت کم میکند؛ و max_concurrent جلوی صفشدن بیپایان کوئریها را میگیرد. اگر پلاگین reload فعال باشد، تغییر ConfigMap خودکار اعمال میشود؛ در غیر این صورت:
kubectl -n kube-system rollout restart deployment coredns
برای کلاسترهای بزرگ، تعداد replica را بالا ببرید و منابع بدهید:
kubectl -n kube-system scale deployment coredns --replicas=4
kubectl -n kube-system autoscale deployment coredns --min=2 --max=10 --cpu-percent=60
چطور بفهمیم مشکل واقعاً حل شده است
- روی یک پاد جدید چک کنید که
resolv.confدرست نوشته شده باشد:kubectl exec -it deploy/api -- cat /etc/resolv.confو بایدoptions ndots:2 timeout:1را ببینید. - در پاد تست، تعداد کوئریها را دوباره با
tcpdumpبشمارید. برایapi.stripe.comباید فقط یک یا دو کوئری (A و AAAA) ببینید، نه هشت کوئری. - زمان lookup را اندازه بگیرید:
kubectl exec -it tmp-dns -- dig +stats api.stripe.comو مقدارQuery timeباید تکرقمی میلیثانیه باشد. - متریک CoreDNS را زیر بار واقعی رصد کنید. نرخ
coredns_dns_responses_total{rcode="NXDOMAIN"}باید بهطور محسوسی افت کند (معمولاً بیش از ۵۰٪). - نمودار تأخیر p99 اپلیکیشن را بعد از دیپلوی مقایسه کنید؛ حذف پیکهای ۵ ثانیهای بهترین تأیید است.
پیشگیری و بهترین روشها
- ndots را با workload هماهنگ کنید. مقدار ۲ انتخاب امن پیشفرض برای اکثر تیمهاست؛ آن را در قالب (template) دیپلویمنتها بگذارید تا برای همه سرویسها اعمال شود.
- در مسیرهای داغ از FQDN با نقطه پایانی استفاده کنید. یک کاراکتر، هفت کوئری اضافه را حذف میکند.
- CoreDNS را مانیتور کنید، نه فقط اپلیکیشن. داشبورد روی
coredns_dns_requests_totalوcoredns_dns_responses_totalبسازید و برای نرخ NXDOMAIN هشدار بگذارید. - برای CoreDNS حتماً requests/limits تعیین کنید. بدون آن، HPA بیاثر است و CoreDNS زیر بار throttled میشود.
- در کلاسترهای پرترافیک NodeLocal DNSCache را استاندارد کنید. این تنها راه حل قطعی race کانترک UDP در kube-proxy است.
- NetworkPolicy روی پورت ۵۳ UDP/TCP را فراموش نکنید. اگر CoreDNS از برخی نودها قابل دسترس نباشد، همان الگوی ۵ ثانیهای برمیگردد.
- بعد از هر تغییر DNS، تست بار بگیرید. ابزارهایی مثل
dnsperfیا یک اسکریپت ساده حلقهای، رگرسیون را قبل از کاربر پیدا میکنند.
درس عملی: هر بار که در Kubernetes یک تأخیر «گرد و ثابت» میبینید، اول DNS و مقدار ndots را چک کنید. این مشکل انقدر رایج است که میارزد برایش یک مرحله ثابت در runbook تیم داشته باشید.
نویسنده
تیم محتوای کلودیکپ
تیم فنی و محتوای کلودیکپ؛ مهندسانی که هر روز با DevOps، Kubernetes و زیرساخت ابری کار میکنند و تجربههایشان را اینجا مینویسند.
سوالات متداول این مقاله
بله، ترتیب جستوجو عوض میشود اما مجموعه نامهایی که resolve میشود یکسان است. با ndots:2 نامهای کوتاه تکبرچسبی مثل redis همچنان از لیست search استفاده میکنند و نامهای دامنهدار خارجی مستقیم مطلق پرسیده میشوند. تنها اثر جانبی، یکیدو درخواست اضافه برای نامهای دوسطحی داخلی مثل my-svc.my-ns است.
اگر پلاگین reload در Corefile فعال باشد (در Corefile پیشفرض kubeadm فعال است) تغییر خودکار حداکثر طی یک دقیقه اعمال میشود. اگر مطمئن نیستید یا تغییرات را نمیبینید، با kubectl -n kube-system rollout restart deployment coredns ریاستارت کنید.
کاهش ndots تعداد کوئریها را کم میکند، اما مسیر بستههای UDP همچنان از iptables و conntrack رد میشود و احتمال گم شدن بسته باقی میماند. NodeLocal DNSCache با یک listener محلی روی هر نود، هم latency را کاهش میدهد و هم race کانترک را حذف میکند. برای کلاسترهای کوچک، تنطیم ndots و dnsConfig کافی است؛ برای کلاسترهای بزرگ هر دو را انجام دهید.
کلودیکپ در این زمینه چه کمکی میکند؟
معماری زیرساخت ابری
طراحی زیرساخت مقیاسپذیر، امن و مقرونبهصرفه روی AWS، Azure یا Google Cloud.
مشاهده جزئیات خدمتKubernetes و مدیریت کانتینر
استقرار، پیکربندی و نگهداری خوشههای Kubernetes برای اجرای مقیاسپذیر برنامهها.
مشاهده جزئیات خدمتمهاجرت به ابر
انتقال ایمن و برنامهریزیشده زیرساخت و برنامهها از سرورهای سنتی به فضای ابری.
مشاهده جزئیات خدمت
پاد Kubernetes در وضعیت Terminating گیر کرده؛ آزادسازی امن
پاد در حالت Terminating گیر کرده و با kubectl delete پاک نمیشود؟ این مقاله علت واقعی (finalizer باقیمانده، نود NotReady، ولوم گیرکرده) و راهحل گامبهگام امن را نشان میدهد.
رفع dkim=none در Postfix با راهاندازی OpenDKIM
اگر ایمیلهای سرور Postfix شما در Gmail به اسپم میروند و هدر پیام dkim=none نشان میدهد، یعنی هیچ امضای DKIM روی پیامها درج نمیشود. در این مقاله OpenDKIM را نصب، پیکربندی و به Postfix وصل میکنیم و رکورد DNS را منتشر میکنیم.
«idle in transaction» در PostgreSQL: قاتل خاموش autovacuum
نشستهای idle in transaction تراکنش را باز نگه میدارند، جلوی autovacuum را میگیرند و جدولها را باد میکنند تا جایی که دیسک پر و اتصالها تمام میشود. این مقاله تشخیص و درمان کامل آن است.
در پیادهسازی به کمک نیاز دارید؟
تیم کلودیکپ همین کار را هر روز برای تیمهای دیگر انجام میدهد. اگر جایی گیر کردهاید، با ما صحبت کنید.